
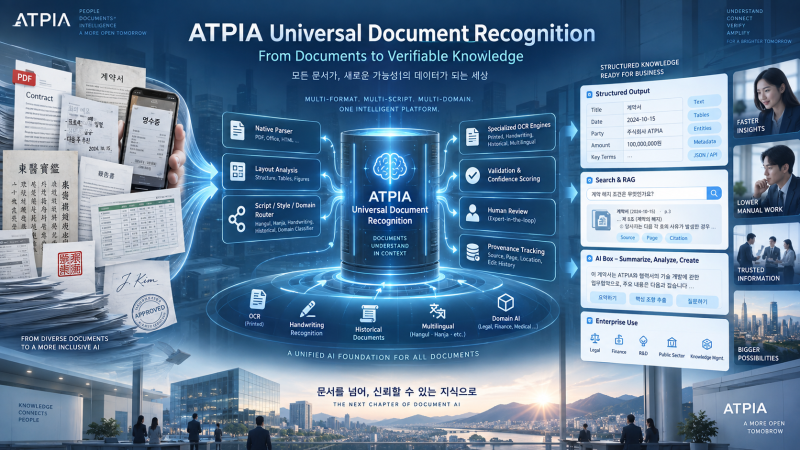
AI 기술기업 ATPIA가 다양한 문서를 하나의 공통 구조에서 인식·검증·활용하는 ‘ATPIA Universal Document Recognition’ 개발을 본격화했다. 이번 프로젝트의 목표는 단순히 글자를 OCR로 바꾸는 데 그치지 않는다. PDF, 스캔 이미지, 휴대전화 촬영문서, 손글씨, 한자·한글 혼합문서, 고문서와 각종 기업 문서를 원문 증거와 구조를 보존한 채 데이터로 전환하고, 이후 검색·RAG·업무자동화에서 다시 근거를 추적할 수 있는 ‘검증 가능한 지식’으로 연결하는 것이다.
“문서 → 구조화 → 검증 → 지식 → 업무자동화” |
하나의 OCR이 아니라 ‘문서 인식 플랫폼’
ATPIA Universal Document Recognition은 하나의 거대 모델에 모든 문서를 맡기는 방식과 거리를 둔다. 문서가 가진 형식과 언어, 문자, 작성방식, 레이아웃에 따라 가장 적합한 전문 Provider를 선택하고, 각각의 결과를 공통 Recognition Schema로 통합하는 Multi-engine 구조가 핵심이다.
텍스트 레이어가 살아 있는 PDF나 DOCX·HWPX·TXT·XLSX·HTML은 OCR보다 원문 구조를 우선 활용하는 ‘Native-text First’ 원칙을 적용한다. 반대로 이미지 기반 PDF나 사진 문서는 rasterization과 OCR을 거치고, 제목·본문·표·그림·수식·코드·도장·서명·각주 같은 영역을 분리한 뒤 문자와 스타일, 문서 도메인에 맞춰 인식 경로를 결정한다.
인식 결과를 다루는 방식도 일반적인 OCR 서비스와 다르다. 최초 raw OCR은 덮어쓰지 않고 그대로 보존하며, 사람이 검토한 reviewed text와 수정 이력을 별도로 저장한다. 모델명과 버전, checkpoint·dataset·전처리·후처리·정책 hash 등 재현성 정보도 함께 기록하도록 설계했다. 신뢰도가 낮은 결과는 자동으로 ‘정답’으로 꾸미지 않고 REVIEW_REQUIRED 상태로 보내는 confidence-aware 방식도 핵심 원칙이다.
문서에서 RAG와 업무 Pack까지, 한 흐름으로
Document → Native Parser / Image Preflight → Layout Analysis → Router → OCR · VLM → Validation / Review → RAG · Business Pack
이 구조는 ATPIA가 개발 중인 AI Box와 직접 연결된다. Recognition 결과에는 document_id와 page_id, region_id, bbox, raw_text, reviewed_text, confidence, provider 등의 메타데이터가 남고, 이후 Chunking → Embedding → pgvector → RAG 과정에서도 이 정보가 유지된다. 사용자가 AI의 답변을 확인할 때 ‘어느 문서의 몇 페이지, 어떤 영역에서 나온 정보인가’를 다시 복원할 수 있도록 설계한 이유다.
문서 한 페이지의 OCR이 실패했다고 전체 문서를 무조건 실패 처리하지 않고 PARTIAL_SUCCESS를 지원하는 것도 기업 현장을 염두에 둔 선택이다. 완벽한 자동화보다 실패를 숨기지 않고 검토 가능한 상태로 남기는 것이 법률·행정·회계·기술문서처럼 원문 근거가 중요한 영역에서 더 실용적이라는 판단이다.
Phase 2에서 ‘실제 돌아가는 Baseline’까지 확인
9월 6일 정리된 Phase 2 최종보고서에 따르면 Universal Document Recognition은 G0 Architecture 단계에서 PASS를 받았고, G1 Baseline은 PARTIAL 상태다. 아직 전체 문서군에 대한 Gold benchmark가 충분하지 않아 Production Ready 단계라고 볼 수는 없지만, 아키텍처 문서 수준을 넘어 실제 이미지와 image-only PDF를 처리하는 baseline pipeline은 확인했다.
구분 | 현재 판정 | 확인된 내용 |
|---|---|---|
G0 Architecture | PASS | Schema·Provider·Registry 등 기반 구조 확정 |
G1 Baseline | PARTIAL | 실제 CPU OCR·image-only PDF·Review·citation 검증 |
G2 Fine-tune | NOT READY | 실제 손글씨 데이터와 고정 Gold 보강 필요 |
Production | NOT READY | 성능·보안·운영 Gate 추가 통과 필요 |
실제 PaddleOCR 3.7.0을 별도 Python 3.11 runtime으로 분리해 PNG/JPEG 인식을 수행했고, ‘ATPIA 문서 인식 2026 / Legal KPI 30%’ 샘플에서 confidence 0.9621의 Recognition block을 얻었다. Image-only PDF도 pypdfium2를 통해 page PNG로 변환한 뒤 OCR까지 연결하는 흐름을 검증했다.
Review UI에서는 원본 페이지와 bbox overlay, raw OCR, reviewed text를 분리해 확인할 수 있도록 구현했고, SQLite 통합 테스트에서 RAG citation이 page·region·bbox로 다시 복원되는 것도 확인했다. Backend pytest는 38 passed, frontend typecheck/build도 통과했다.
GPU 문제도 단순한 라이브러리 설치 실패가 아니라 실행 프로세스에 NVIDIA device가 전달되지 않는 ‘device boundary’ 문제로 진단했다. 이를 바탕으로 GPU preflight, systemd DeviceAllow, Compose gpus 설정 등 운영 경계를 보강했다. 다만 실제 Paddle GPU runtime benchmark와 전체 Gold 문서군 검증은 다음 단계로 남아 있다.
흩어져 있던 기술이 하나의 포트폴리오로 연결된다
이번 Universal Document Recognition 개발이 갖는 의미는 OCR 기능의 추가보다 더 크다. ATPIA가 그동안 개발해 온 Language AI, Multimodal AI, Speech AI, 문자·지식 데이터, 고문서 인식, Local AI 인프라가 ‘기업의 실제 문서를 이해하고 활용하는 과정’에서 서로 연결되기 시작했기 때문이다.
ATPIA 포트폴리오 | 역할 | Universal Document Recognition과의 연결 |
|---|---|---|
Qwen3 | Language AI | 인식된 문서를 기반으로 질의·요약·업무 생성 |
Qwen VL | Multimodal AI | 복합 레이아웃·이미지 문서의 fallback 및 보조 검증 |
Qwen TTS | Speech AI | 문서·지식 결과를 음성 인터페이스로 확장 가능 |
ATPIA 한자 자전 | Knowledge AI | 한자·이체자·문자 지식 자산과 문서 인식의 연계 기반 |
Historical OCR | Specialized Document AI | 세로쓰기·고한자·고문서를 담당하는 전문 Provider |
ATPIA AI Box | Enterprise Local AI | RAG·검색·법률·행정·회계·기술 업무 Pack으로 연결 |
특히 기존 Historical OCR은 Universal Document Recognition에 흡수되어 사라지는 프로젝트가 아니다. 오히려 세로쓰기와 고한자, 역사문헌을 담당하는 전문 HistoricalDocumentProvider로 재사용되는 구조다. 범용 플랫폼 위에 전문 인식 기술을 꽂아 넣는 방식이어서 앞으로 산업별·문서별 Provider를 추가하기도 쉬워진다.
allocr.atpia.com, 향후 범용 문서 인식 서비스의 공개 진입점
개발계획서 v1.1은 Universal Document Recognition을 향후 allocr.atpia.com에서 독립 서비스로 운영하기 위한 배포·보안 계획도 함께 제시했다. 계획상 사용자는 한 도메인에서 로그인, 문서 업로드, 처리 상태 확인, OCR 결과 Review, JSON·TXT·Markdown export 등을 이용하고, 내부적으로는 API·PostgreSQL/pgvector·storage·worker·GPU OCR runtime·Ollama/Qwen을 private network에 두는 구조다.
다만 이 도메인은 현재 ‘서비스 오픈 완료’를 의미하지 않는다. 문서에도 Production NOT READY가 명시되어 있으며, DNS·TLS·인증·GPU runtime·backup/restore·tenant isolation·rate limit·canary 등 별도 운영 Gate를 통과한 뒤 제한적으로 공개하는 것이 원칙이다. ATPIA는 정확도가 낮은 문서에 대해 자동 정답을 만들어 내기보다 REVIEW_REQUIRED 또는 UNSUPPORTED 상태를 명확히 표시하는 방향을 택했다.
다음 퍼즐은 손글씨·Gold Benchmark·GPU Fine-tuning
다음 단계의 핵심은 ‘얼마나 많은 기능을 붙였는가’보다 ‘얼마나 객관적으로 정확도를 증명할 수 있는가’에 있다. ATPIA는 printed-ko-clean 한 건에 머문 현재 Gold fixture를 영문·법률·기술·손글씨·한자 혼합·고문서 등 전체 문서군으로 확대하고, licensed dataset과 writer-disjoint split을 고정한 뒤 CRNN·TRBA·TrOCR 계열의 CUDA fine-tuning을 비교할 계획이다.
이와 함께 selective-risk threshold, Review 처리량, provider별 latency와 실패율, backup/restore, 보안·rollback rehearsal까지 통과해야 Pilot과 Production 단계로 넘어갈 수 있다. 즉, 이번 Phase 2는 ‘완성품 선언’이 아니라 ATPIA가 범용 Document AI를 실제 제품 수준으로 끌어올리기 위한 기술적 기준선을 세웠다는 데 의미가 있다.
모델에서 문서로, 문서에서 지식으로… ATPIA 포트폴리오가 향하는 곳
ATPIA의 포트폴리오는 이제 개별 AI 데모를 늘리는 단계에서 “모델 → 문서 → 지식 → 기업 업무”를 연결하는 방향으로 빠르게 정리되고 있다. Qwen3와 Qwen VL이 언어와 시각을 담당하고, 한자 자전과 Historical OCR이 전문 지식·문자·고문서 영역을 확장하며, Universal Document Recognition이 다양한 문서를 공통 지식 구조로 바꾼다. 그 결과는 다시 ATPIA AI Box의 검색·RAG·법률·행정·회계·기술 업무로 이어진다.
기업 현장에서 AI가 실제로 일을 하려면 ‘좋은 모델’만으로는 부족하다. 계약서와 보고서, 스캔 문서와 영수증, 손글씨와 오래된 기록처럼 현실의 자료를 안전하게 읽고, 틀릴 수 있는 부분을 사람에게 보여주며, 답변의 근거를 다시 원문까지 추적할 수 있어야 한다. ATPIA Universal Document Recognition은 바로 그 빈틈을 메우기 위한 기술이다.
아직 Production까지 가야 할 단계는 남아 있다. 그러나 ATPIA는 이번 Phase 2를 통해 범용 문서 인식의 공통 Schema와 Provider 구조, 실제 OCR baseline, Review와 citation, GPU 운영 경계까지 연결했다. 여러 개의 기술 프로젝트가 하나의 기업용 AI 생태계로 맞물리기 시작했다는 점에서, ATPIA의 제품 포트폴리오는 이제 ‘무엇을 만들 것인가’를 넘어 ‘어떻게 서로 연결해 실제 업무에 쓰게 할 것인가’라는 다음 단계로 들어서고 있다.
개발 단계 고지 본 기사에서 소개한 ATPIA Universal Document Recognition은 2026년 9월 6일 기준 G0 Architecture PASS / G1 Baseline PARTIAL 상태이며 Production Ready가 아니다. 성능 수치는 제한된 fixture에서의 개발 검증 결과로 상용 서비스의 성능 보장치가 아니다. |
기사 작성 기준 자료
· ATPIA Universal 문서 인식 시스템 개발계획서 v1.1 · allocr.atpia.com 배포 운영 프로파일 (2026-09-06)
· ATPIA Universal 문서 인식 시스템 최종보고서 · Phase 2 (2026-09-06)